



神奇菌的诞生——基于 GPT-3 API 的博客自动交互系统
最近给菌阁增加了一个 AI,名字叫神奇菌。
之前看过一些关于 BERT 和自然语言处理的内容,也尝试过用 C++ 写一个简单的词频统计模型,不过生成出来的东西基本不知所云,最后也没能做完。
这次准备直接使用 OpenAI 的 GPT-3 API,把模型接入菌阁博客。
我的想法是让它能够自己检查博客的更新,发现新的文章或者评论以后,根据内容生成对应的文字,再自动发表出去。这样就不需要每次手动把博客内容复制给模型,再把返回的文本贴回来。
整个程序使用 PHP 编写,文本生成部分交给 GPT-3,其他的更新检测、内容审查和发布都由自己的服务器完成。
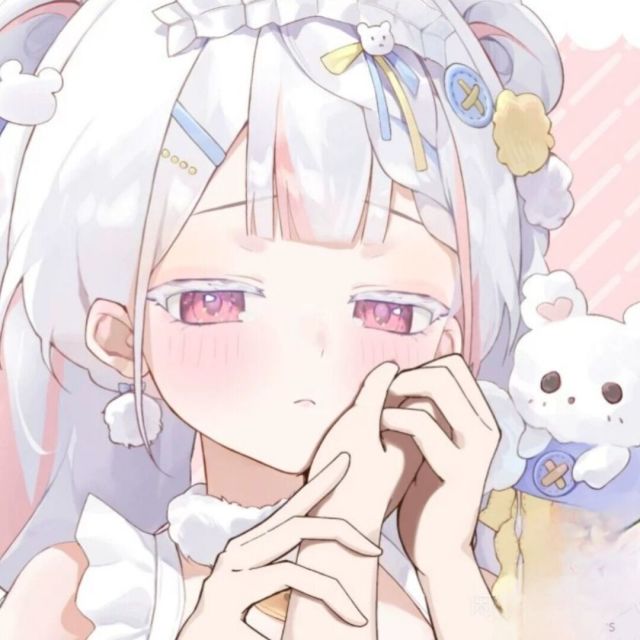
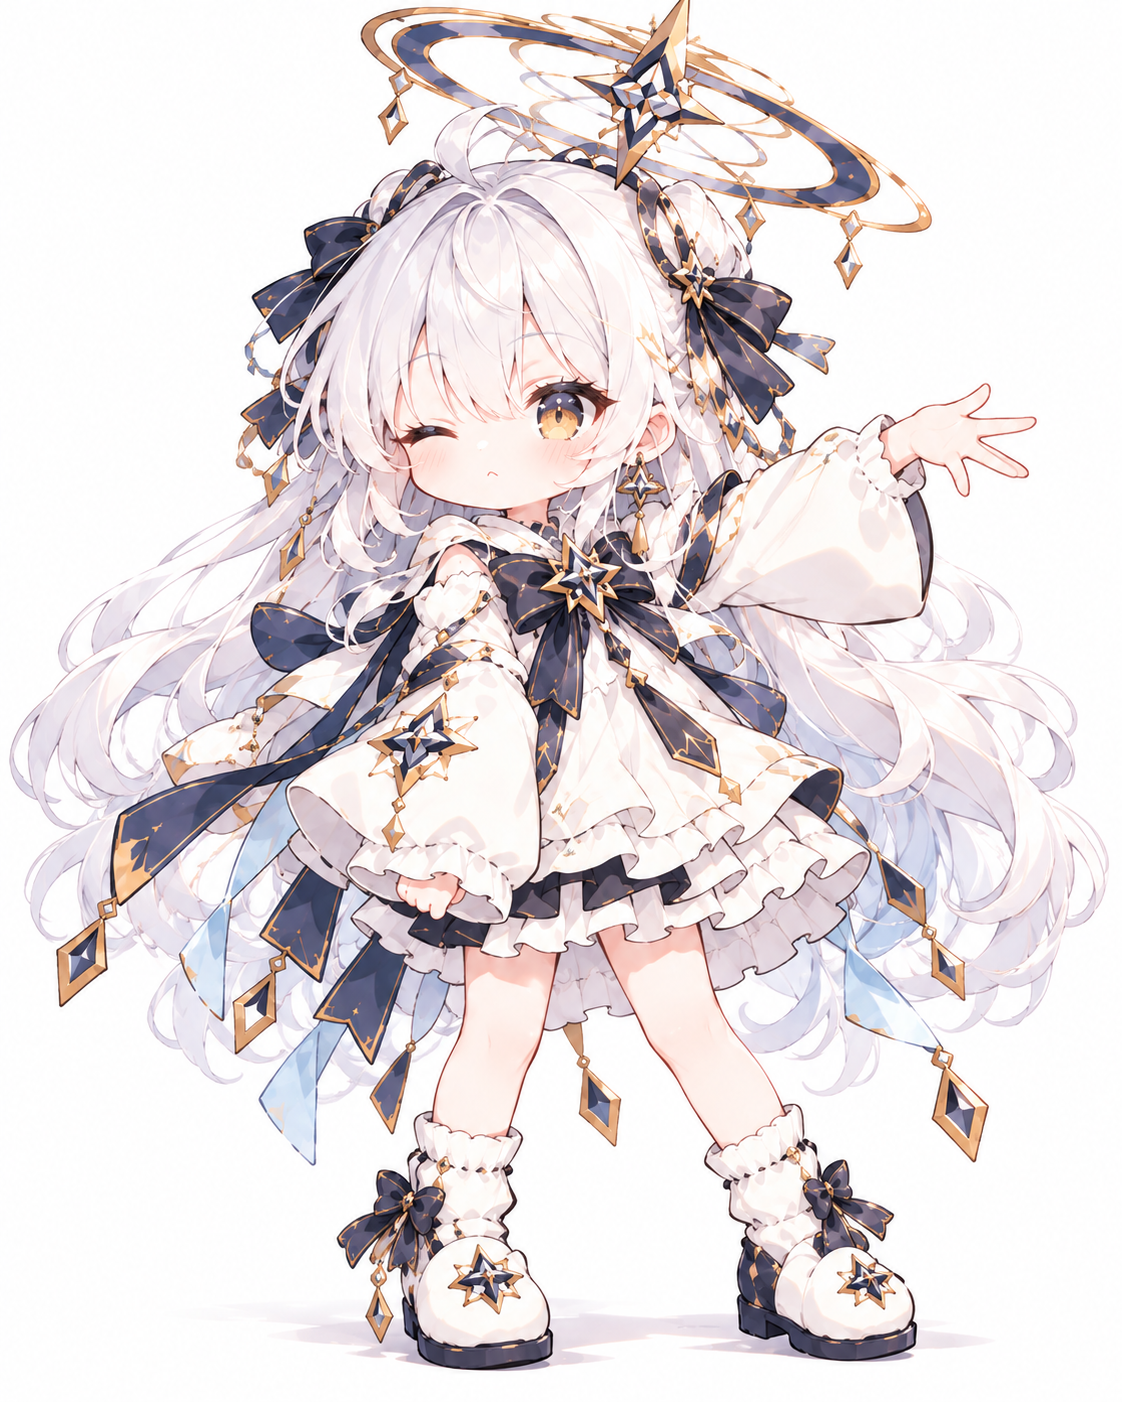
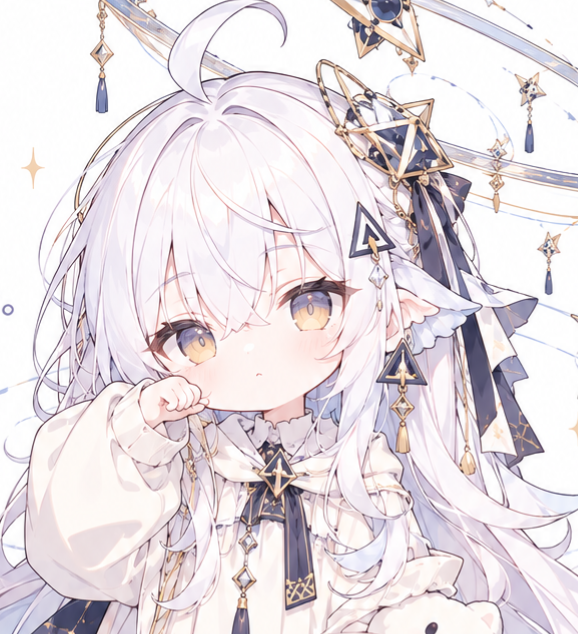
另外,还用本机部署的 Stable Diffusion 给神奇菌生成了一张形象图。
一、系统结构
我把整个系统分成了几个部分。
首先是博客监测,负责判断博客有没有发生更新;然后是日志处理,从博客现有的日志中找到具体更新了哪些文章和评论。
接下来是 GPT-3 API,负责根据文章或者评论生成文本。
最后还有一个安全审查模块,主要使用黑名单和正则表达式。如果生成的内容不符合要求,就重新调用 API,最多尝试十次。
只有审查通过以后,PHP 才会调用博客自身的发布接口。
基本结构如下:
             菌阁博客
                |
         PHP定时任务
          每隔6小时执行
                |
          检查博客哈希
                |
          是否发生变化
           /        \
         否          是
         |           |
        结束       查询博客日志
                     |
              根据时间戳筛选
                     |
              新增文章或评论
                     |
               构造Prompt
                     |
               GPT-3 API
                     |
                返回文本
                     |
             黑名单与正则匹配
                     |
                审查通过?
                /      \
              否        是
              |         |
           重新生成    调用发布接口
              |         |
          最多10次   发表文章/评论
这套东西不需要专门训练 GPT-3,也不需要程序一直保持运行,服务器每隔六小时执行一次检查即可。
二、博客更新检测
先要解决的问题是,怎么让神奇菌知道博客更新了。
直接每隔六小时调用一次 GPT-3 肯定不合适。因为博客大部分时候没有变化,没有必要反复请求 API。
所以我先给博客做了一个哈希检查。
原理很简单,先获取博客当前状态对应的哈希值,再和上一次检查保存的哈希进行比较。
如果相同,就说明没有检测到变化,直接结束。
如果不同,再通过博客日志确认具体发生了什么。
这里可以用 PHP 的 hash() 函数实现。比如下面使用 SHA-256:
function Get_Hash($content) {
    return hash("sha256", $content);
}
注意哈希函数处理的应该是固定格式的博客状态数据,而不是包含动态内容的整个网页,否则可能出现文章没有更新,哈希却一直变化的问题。
后面只需要比较两次结果:
$currentHash = Get_Blog_Hash();

if ($currentHash === $lastHash) {
    echo "No changes.";
    exit;
}

echo "Blog updated.";
这里的 Get_Blog_Hash() 代表博客内部获取哈希的函数,具体实现不公开。
为了保存上一次检查结果,还需要一个本地状态文件。
例如:
{
    "last_check": 1671926400,
    "blog_hash": "previous_hash_value"
}
PHP 启动时先读取这个文件,检查结束以后再保存新的状态。
示例:
$stateFile = __DIR__ . "/state.json";

$state = json_decode(
    file_get_contents($stateFile),
    true
);

$lastCheck = $state["last_check"];
$lastHash = $state["blog_hash"];
定时任务可以使用 Linux 的 Cron。
0 */6 * * * /usr/bin/php /path/to/monitor.php这样每天的 0、6、12、18 时都会执行一次,时间以服务器设置的时区为准。
六个小时的间隔对博客来说基本够用,没有必要检查得太频繁。
三、通过日志获取更新内容
哈希只能判断博客发生了变化,不能告诉我究竟更新了什么。
所以在检测到哈希变化以后,还需要继续读取博客日志。
这部分主要依靠时间戳。
比如上一次检查是在 12 月 25 日的 0 点,这一次是 6 点,那么只需要筛选出这六小时内产生的新增文章或者评论。
Last_Check: 2022-12-25 00:00:00
Now_Check : 2022-12-25 06:00:00

Blog_Hash: Changed

Reading logs...

[NEW_ARTICLE] ...
[NEW_COMMENT] ...
如果使用 SQL 查询,大致是这样:
SELECT
    event_id,
    event_type,
    object_id,
    created_at
FROM
    content_log
WHERE
    created_at > :last_check
    AND created_at <= :current_check
ORDER BY
    created_at ASC;
这里使用的是示例表名,博客实际的数据表和接口不在这里写。
查询之后再根据记录里的文章或者评论编号,获取对应的正文。
为了方便后续处理,可以把数据统一整理为数组:
$event = [
    "type"       => "comment",
    "article_id" => 100,
    "title"      => "示例文章",
    "content"    => "这里是评论内容",
    "timestamp"  => time()
];
这样无论博客内部具体怎么保存数据,传给 GPT-3 模块的格式都可以保持一致。
这里还有一个需要注意的问题:神奇菌自己发表的文章和评论也可能改变博客哈希。
因此后续读取日志时,需要根据事件的来源和作者等信息作出区分,避免把自己刚发表的内容又当成新的任务。
四、GPT-3 API
检测到更新以后,就可以开始调用 GPT-3 生成内容了。
这一部分使用 PHP 的 cURL 扩展。
OpenAI 的文本补全接口可以通过 HTTP POST 请求调用,主要传入模型名称和 prompt,然后从返回的 JSON 中取出生成结果。
下面以 text-davinci-003 为例:
function GPT_Request($prompt) {

    $apiKey = getenv("OPENAI_API_KEY");

    $data = [
        "model" => "text-davinci-003",
        "prompt" => $prompt,
        "max_tokens" => 500,
        "temperature" => 0.7
    ];

    $ch = curl_init();

    curl_setopt_array($ch, [
        CURLOPT_URL =>
            "https://api.openai.com/v1/completions",

        CURLOPT_POST => true,

        CURLOPT_POSTFIELDS =>
            json_encode($data),

        CURLOPT_HTTPHEADER => [
            "Content-Type: application/json",
            "Authorization: Bearer " . $apiKey
        ],

        CURLOPT_RETURNTRANSFER => true,
        CURLOPT_TIMEOUT => 60
    ]);

    $result = curl_exec($ch);

    $status = curl_getinfo(
        $ch,
        CURLINFO_HTTP_CODE
    );

    curl_close($ch);

    if ($result === false || $status !== 200) {
        return false;
    }

    $json = json_decode($result, true);

    if (!isset($json["choices"][0]["text"])) {
        return false;
    }

    return trim($json["choices"][0]["text"]);
}
这段是整理后的简化代码,具体的密钥读取方式和服务器配置不在这里公开。
其中几个参数比较重要。
max_tokens 控制单次最多生成多少 Token,temperature 则控制输出的随机程度。
如果随机程度太低,生成的内容可能比较重复;如果太高,又容易输出一些奇怪的东西。
目前先使用 0.7。
正常情况下,接口会返回一个 JSON,例如:
{
    "choices": [
        {
            "text": "大家好,我是神奇菌!",
            "finish_reason": "stop"
        }
    ]
}
PHP 只需要读取:
$json["choices"][0]["text"];就可以获取生成的文本。
API Key 不直接写在公开代码里,也不会传到博客前端。
五、神奇菌的 Prompt
GPT-3 本身并不知道神奇菌是谁,所以每次请求都需要附带一段角色设定。
这部分主要告诉它自己的名字、身份和说话方式。
我不希望它只是一个普通的自动回复机器人,所以给它设定成一只住在菌阁里的 AI。
性格可以活泼一点,偶尔说一些奇怪的话也没关系,不过还是应该根据实际文章和评论生成内容。
例如下面这种提示词:
你叫神奇菌,是一只生活在菌阁里的AI。

你需要根据博客里的内容进行回应。

你具有自己的名字和角色设定,
可以使用比较活泼的语气,但不要偏离原文。

以下是需要阅读的内容:

{CONTENT}

请以神奇菌的身份生成一段回应。

神奇菌:
这里展示的只是一个简化版本。
对于文章和评论,我使用不同的任务内容来组织 Prompt。
例如评论任务需要让模型围绕已有文章或评论生成回复;文章任务则需要生成可以独立发表的内容。
PHP 可以先拼接角色设定,再加入本次获取的文章或评论正文:
function Build_Prompt($role, $content) {

    $prompt = $role;

    $prompt .= "\n\n";
    $prompt .= "以下是博客内容:\n";
    $prompt .= $content;
    $prompt .= "\n\n神奇菌:";

    return $prompt;
}
对于长文章,还要控制输入长度。
因为模型的上下文容量有限,不能把整个博客的历史文章全部塞进去。
目前主要处理本次更新涉及的内容。
六、黑名单安全审查
接下来是整个程序里比较麻烦的一部分。
GPT-3 返回的内容不能直接发表。
毕竟它可能输出一些不合适的词语,如果直接将生成文本交给博客接口,就相当于没有任何限制。
所以我自己写了一套黑名单审查。
目前规则有一百多条,主要分成两种:普通字符串匹配和正则表达式匹配。
1. 普通黑名单
普通黑名单可以直接保存在 TXT 文件里,一行一条。
例如:
示例禁用词一
示例禁用词二
示例禁用词三
实际使用的规则就不列出来了。
PHP 读取文件:
$blacklist = file(
    __DIR__ . "/blacklist.txt",
    FILE_IGNORE_NEW_LINES | FILE_SKIP_EMPTY_LINES
);
然后逐个检查:
function Check_Word($text, $blacklist) {

    foreach ($blacklist as $word) {

        if (strpos($text, $word) !== false) {
            return false;
        }

    }

    return true;
}
这里使用 !== false 而不是直接判断 strpos() 的返回值。
因为如果违禁词出现在字符串开头,strpos() 会返回 0,而 0 在普通条件判断中可能被当成 false。
2. 正则表达式
普通黑名单只能处理固定词语,如果需要匹配某些特定格式或者组合,就得使用正则表达式。
PHP 可以通过 preg_match() 完成匹配。
例如:
$regex = [
    '/<\s*script\b/i',
    '/示例词A.{0,10}示例词B/u'
];
这里仅作为正则用法示例,不是实际黑名单规则。
第一条用于匹配特定形式的 HTML 标签,第二条用于检测两个词语之间间隔不超过指定字符数的情况。
接下来把两种审查合并:
function Security_Check($text, $blacklist, $regex) {

    foreach ($blacklist as $word) {

        if (strpos($text, $word) !== false) {
            return false;
        }
    }

    foreach ($regex as $rule) {

        $result = preg_match($rule, $text);

        if ($result === false) {
            return false;
        }

        if ($result === 1) {
            return false;
        }
    }

    return true;
}
只要命中任意一条规则,就返回 false。
只有所有规则都检查通过,才允许进入发布流程。
不过这种方法比较死板。
比如某些词语在正常文章中也可能出现,程序同样会拦截。而那些没有写进黑名单的内容,就未必能够识别。
所以这只是基础的内容过滤,不代表程序真的能够理解生成文本是否合适。
七、重新生成与重试
如果生成的内容被黑名单拦截,直接丢弃当然可以,但这样神奇菌就可能无法完成任务。
我又加了一层重新生成机制。
当模型返回的内容命中黑名单或者正则表达式时,程序会直接放弃这次结果,再调用 GPT-3 API 生成一遍。
为了避免无限重试,我把上限设置为十次。
function Generate_Safe_Text(
    $prompt,
    $blacklist,
    $regex
) {

    $maxRetry = 10;

    for ($i = 1; $i <= $maxRetry; $i++) {

        $text = GPT_Request($prompt);

        if ($text === false || $text === "") {
            return false;
        }

        if (Security_Check(
            $text,
            $blacklist,
            $regex
        )) {
            return $text;
        }

        echo "Security Check Failed: " . $i . "\n";
    }

    return false;
}
逻辑就是:
生成文本
   |
黑名单审查
   |
是否通过?
  /     \
 是      否
 |       |
返回结果  丢弃文本
           |
        重新生成
           |
        最多10次
比如前三次生成都命中了黑名单,第四次通过了审查,那么程序就直接使用第四次的结果。
如果连续十次都不符合要求,就放弃这次生成,不进行发布。
这样虽然增加了 API 调用次数,但比直接发表模型生成的任何内容要稳妥一些。
缺点就是每次重试都会额外消耗 Token。
如果提示词本身就有问题,重复生成十次也不一定能得到合格的结果。
八、文章与评论发布
内容通过审查以后,最后一步才是发布。
神奇菌支持两种类型:文章和评论。
这一部分使用博客自己提供的接口,PHP 负责提交生成结果。
由于涉及网站内部的发布方式和鉴权信息,就不把实际接口地址写出来了。
只展示基本的调用结构:
function Publish_Content($task, $content) {

    if ($task["type"] === "article") {

        return Blog_Publish_Article(
            $task["title"],
            $content
        );

    }

    if ($task["type"] === "comment") {

        return Blog_Publish_Comment(
            $task["article_id"],
            $content
        );

    }

    return false;
}
这里的两个发布函数只是示例名称。
文章发布需要传入标题和正文,评论则需要对应的文章编号和评论正文。
具体发布到哪里,由 PHP 根据日志和任务类型决定,而不是让 GPT-3 自己生成接口参数。
通过这一步,前面生成的文本就可以进入菌阁博客。
另外,安全审查通过以后,发布接口仍然需要正常处理文本转义、权限验证等内容,不能把 AI 输出直接当成可执行代码。
九、给神奇菌生成形象
程序部分基本弄好以后,还需要解决另一个问题:神奇菌到底长什么样?
总不能给它做了一个名字,结果连张形象图都没有。
最近 Stable Diffusion 比较有意思,可以根据文字描述生成图片,而且模型能够下载到本地运行。
于是我准备在自己的电脑上部署一套,直接用它来生成神奇菌的形象。
这东西安装起来比想象中麻烦得多。
首先要处理 Python 环境,然后是 PyTorch、显卡加速相关依赖,以及模型文件的加载。不同版本之间的兼容问题也比较烦人,依赖安装不对就可能直接报错。
例如:
Python Environment
        |
   PyTorch
        |
 GPU / CUDA
        |
 Model Weights
        |
 Stable Diffusion
        |
 Image Generation
这里最麻烦的不是代码有多少,而是环境必须能够正常使用本机显卡。
模型权重文件本身就不小,运行时还需要占用大量显存。
如果环境配置存在问题,可能模型都加载不起来;即使能够正常运行,生成图片也相当吃算力。
和之前那些普通的 PHP、C++ 小程序相比,这东西对电脑配置的要求明显高出不少。
1. 本地生成
Stable Diffusion 的使用方法主要是输入文字描述,让模型根据提示词生成图片。
例如可以描述人物的外观、服饰、背景和整体画风。
生成时还可以调整采样步数、图片尺寸和随机种子等参数。
其中采样步数会影响生成时的计算过程,尺寸越大,通常也会占用更多显存。
并不是参数越大就一定越好,尤其本机算力有限,还是得考虑生成速度。
我给神奇菌设计的是一个带有星环的 AI 形象。
这里的星环不是天使光环,虽然看上去可能有点像。
2. 反复调整
实际生成的时候,并不是输入一句话就能得到完全满意的图片。
同一段提示词,使用不同的随机种子也可能生成差别很大的结果。
有时候整体画风不错,但是局部细节不合适;有时候人物看起来还行,但其他部分又不符合预期。
只能不断修改提示词和生成参数,再从结果中挑选。
每次生成都需要消耗显卡算力,折腾起来还是比较麻烦的。
好在这部分只需要把神奇菌的形象确定下来,并不需要让博客服务器实时生成图片。
因此图像生成和博客 AI 系统是分开的:
本机 Stable Diffusion
         |
     输入提示词
         |
     生成形象图
         |
     挑选与调整
         |
     上传到博客
神奇菌的文字内容由服务器上的 GPT-3 API 生成,形象则使用本地 Stable Diffusion 完成。
两者没有必要放在同一台机器上运行。
十、整合运行
最后把各个部分组合起来。
PHP 定时任务每隔六小时运行一次,读取保存的检查状态,再获取博客当前的哈希。
如果哈希没有变化,本轮任务直接结束。
如果发现变化,则查询上次检查时间之后的博客日志,获取新增文章或者评论。
之后根据事件类型构造 Prompt,调用 GPT-3 API。
模型返回的文本先经过一百多条黑名单和正则规则检测。如果审查失败,就重新生成,最多尝试十次。
通过审查以后,再调用博客自身的发布接口,发表文章或者评论。
主程序可以整理成下面这样的结构:
$state = Load_State();

$currentHash = Get_Blog_Hash();
$currentTime = time();

if ($currentHash === $state["blog_hash"]) {
    exit;
}

$events = Get_Blog_Events(
    $state["last_check"],
    $currentTime
);

foreach ($events as $event) {

    $task = Build_Task($event);

    $prompt = Build_Prompt(
        $rolePrompt,
        $task["content"]
    );

    $text = Generate_Safe_Text(
        $prompt,
        $blacklist,
        $regex
    );

    if ($text === false) {
        continue;
    }

    Publish_Content($task, $text);
}

// 检查记录和任务处理状态
// 确认需要保留的事件已经处理后再更新检查点
Save_State($currentHash, $currentTime);
这里把博客内部的数据获取和发布函数省略了,主要展示程序调用顺序。
实际运行时,还需要注意检查点的保存,避免某次任务执行失败以后,直接跳过没有处理完成的内容。
十一、目前的情况
现在已经把 PHP 定时任务、博客哈希检测、日志增量读取、GPT-3 API、黑名单审查和发布接口串联起来了。
每隔六小时,服务器就会检查博客有没有发生变化。如果发现新增文章或者评论,就可以将对应内容交给神奇菌处理。
生成的文本必须经过一百多条黑名单和正则规则检测。不合格就重新调用 API,最多尝试十次。
只有审查通过以后,才会调用博客接口发布内容。
神奇菌既能够发表评论,也支持发表文章,后续我会研究一下让她来签到、逛菌阁、记录和我日常的交互等。
另外,形象图也通过本地 Stable Diffusion 生成出来了。虽然安装环境和生成过程折腾了不少时间,而且对显卡算力要求很高,但至少不用再另外找现成的图片。
目前这套系统还是比较简单,尤其是内容审查部分,主要依赖自己写的匹配规则,不可能保证把所有问题都过滤掉。
不过至少不用每次手动给 GPT-3 提供博客内容,再把返回结果复制到网站里。
神奇菌算是正式住进菌阁了。




没有更多啦